상태 URL이 200을 내보내는데 사용자의 작업은 처리되지 않는다면, 웹 서버가 거짓말한다고 단정하기 전에 상태 URL이 검사하는 조건을 살펴봐야 합니다. HTTP 요청에 응답하는 스레드와 그 뒤의 작업을 담당하는 스레드는 서로 다를 수 있습니다. 외부 기능의 장애도 프로세스 자체를 반드시 종료시키지는 않습니다.
이번 실험은 두 질문을 따로 둡니다. “지금 이 HTTP 프로세스가 응답하는가?”와 “정해 둔 작업을 받을 조건이 갖춰졌는가?”입니다. 실제 서비스의 장애 사례를 가져오지 않고, Python 표준 라이브러리로 작은 서버를 만들어 조건을 한 가지씩 바꿨습니다. 관리자 권한이나 외부 네트워크는 사용하지 않았습니다.
실험에서 실제로 만든 것과 가정한 것
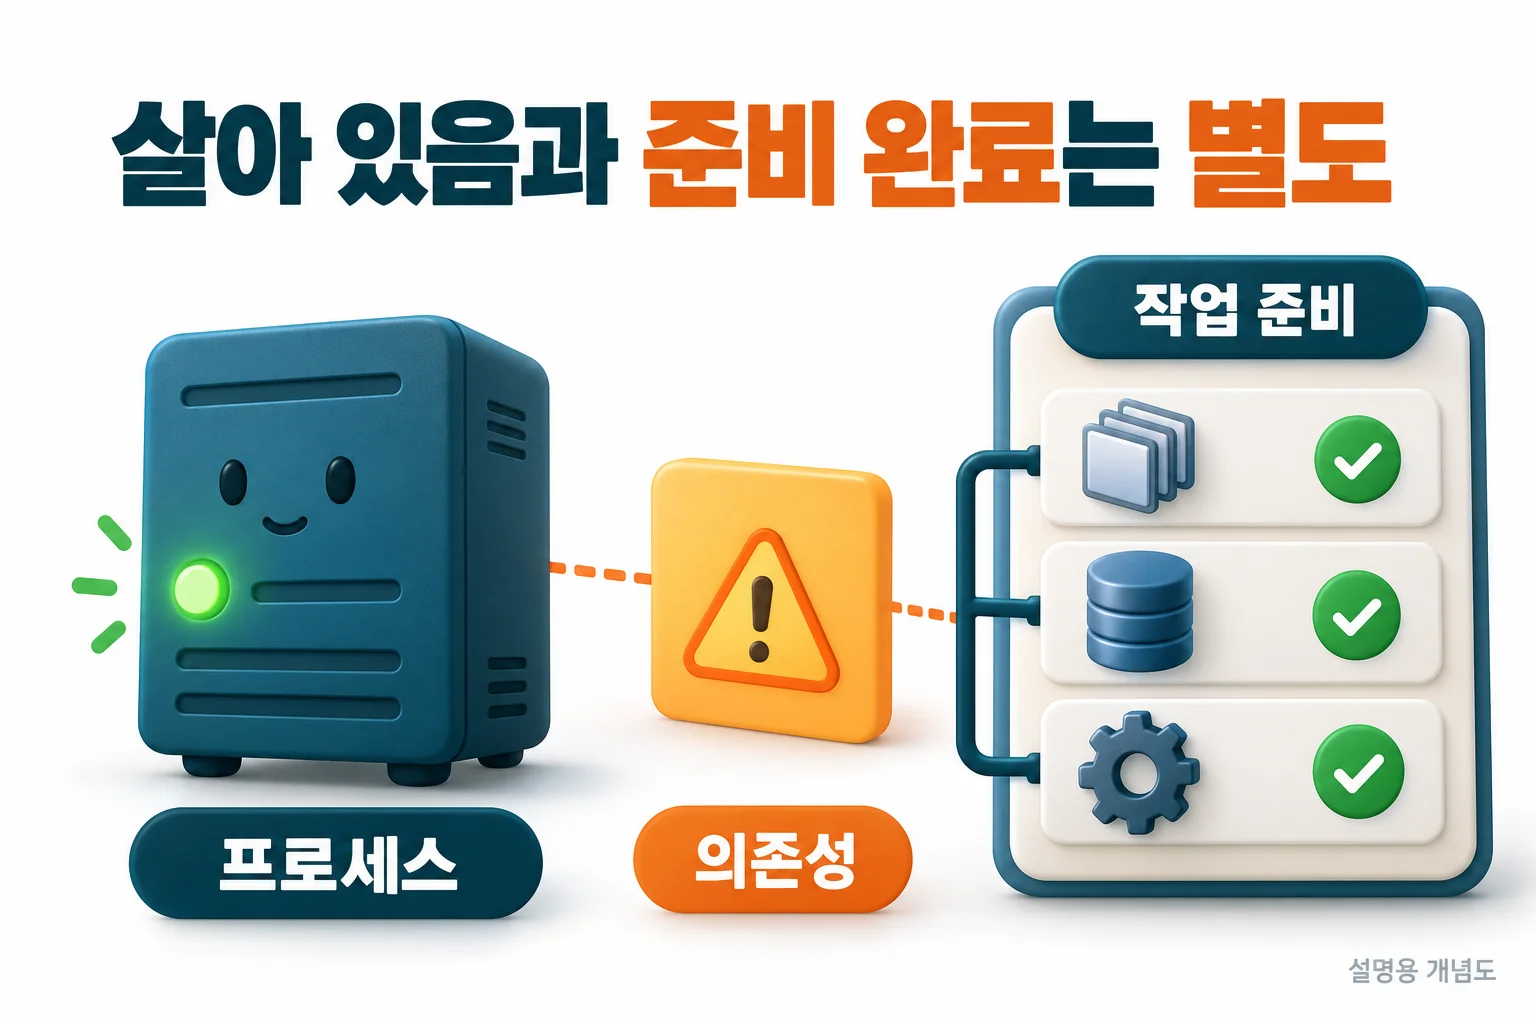
127.0.0.1의 자동 배정 포트에 HTTP 서버를 열고, Event를 기다리는 별도 스레드를 시작했습니다. 이 스레드는 주문이나 파일을 처리하는 구현이 아니라 중지·생존 상태를 관찰할 수 있는 최소한의 대역입니다. 의존성이 준비됐는지는 Boolean 변수로 표현했습니다. 실제 데이터베이스나 외부 API를 고장 낸 실험은 아닙니다.
/healthz는 서버가 요청에 응답할 수 있으면 200을 내보냅니다. /readyz는 대기 스레드가 살아 있고 의존성 변수도 참일 때만 200, 그 외에는 503을 내보내도록 구현했습니다. 경로 이름 자체에 특별한 효과가 있는 것은 아닙니다. 응답을 바꾸는 것은 우리가 작성한 조건식입니다.
| 단계 | 대기 스레드 | 의존성 변수 | /healthz | /readyz |
|---|---|---|---|---|
| 정상 | 살아 있음 | 참 | 200 | 200 |
| 의존성 불가 | 살아 있음 | 거짓 | 200 | 503 |
| 대기 스레드 중지 | 종료 | 참 | 200 | 503 |
| 대기 스레드 복구 | 새 스레드 시작 | 참 | 200 | 200 |
200 응답이 틀린 것이 아니라 질문이 다르다
가운데 두 단계에서도 /healthz의 200은 이 HTTP 서버가 응답했다는 관찰과 일치합니다. 다만 그 결과를 작업 전체가 정상이라고 확대하면 실험 조건과 다른 판단이 됩니다. 이 두 상태를 구분하려고 /readyz를 만든 것이며, 503 응답의 본문에는 스레드와 의존성 상태를 각각 넣었습니다.
네 번째 단계에서는 스레드를 다시 시작하자 /readyz가 200으로 돌아왔습니다. HTTP 서버를 재시작하지 않아도 준비 상태가 회복될 수 있음을 이 작은 구현에서 확인했습니다. 이것을 모든 실제 장애가 작업 스레드만 재시작하면 해결된다는 주장으로 읽어서는 안 됩니다.
Kubernetes 용어를 참고하되 실험 범위를 구분하기
Kubernetes 공식 문서는 liveness를 재시작 판단에, readiness를 트래픽을 받을 준비 상태 판단에 사용하는 프로브로 구분합니다. 준비 검사 실패와 컨테이너 종료는 같은 동작이 아닙니다. 자세한 동작은 공식 프로브 안내에서 확인할 수 있습니다.
이번에는 Kubernetes를 설치하거나 Pod를 운영하지 않았습니다. 문서는 질문을 나누는 기준을 참고한 출처이고, 위 표는 별도로 작성한 Python HTTP 서버의 관찰입니다. 표의 결과가 Kubernetes의 설정 검증을 대신하지는 않습니다.
실서비스에서 먼저 적을 준비 조건
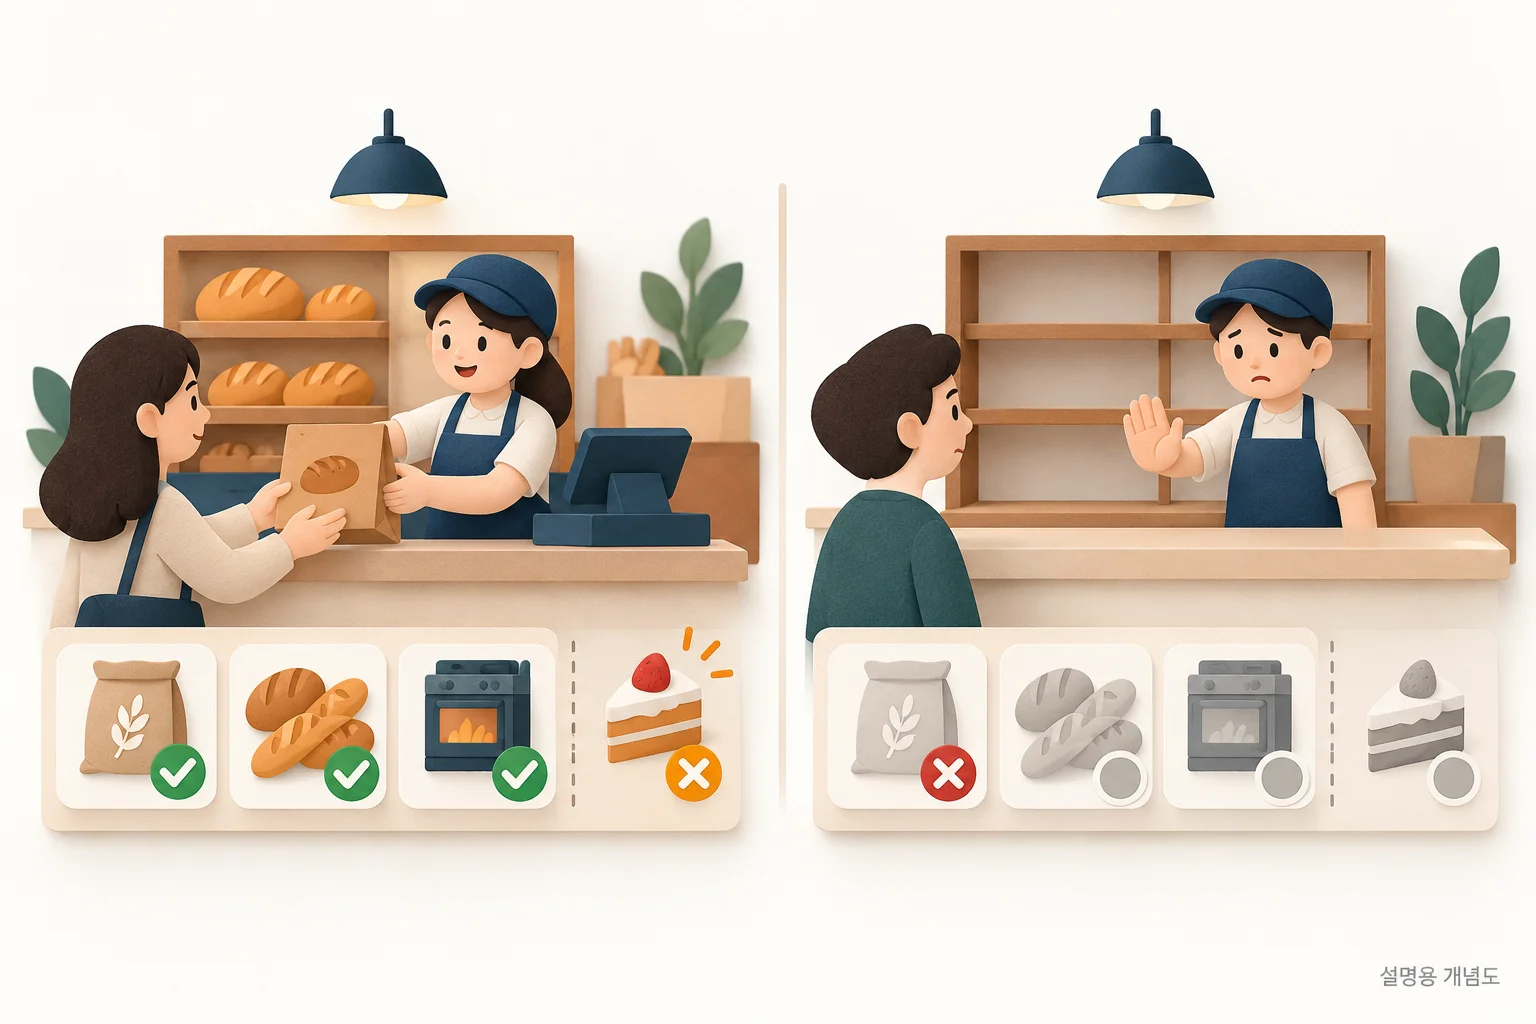
점검 URL을 추가하기 전에 “무엇을 할 수 있어야 준비됐다고 볼 것인가”를 문장으로 써 보세요. 저장 기능이라면 쓰기 조건이, 읽기 전용 서비스라면 사용할 자료의 존재가 중요할 수 있습니다. 선택 기능 하나의 장애를 전체 서비스 중단 조건으로 묶으면 사용할 수 있는 기능까지 내릴 수 있으므로 필요한 조건과 선택 조건을 분리해야 합니다.
검사마다 외부 요청을 보내는 방식과 최근 내부 성공 상태를 읽는 방식은 비용과 의미가 다릅니다. 후자를 쓴다면 성공 여부뿐 아니라 그 성공 시각과 허용할 자료 나이를 함께 정해야 합니다. 오래전의 참 값만 계속 읽으면 의존성이 멈춘 뒤에도 준비됐다고 표시할 수 있습니다. 이 실험의 Boolean 대역에는 시간 만료나 실제 작업 완료 검사가 없으므로 운영 주기·시간 제한의 권장값을 얻은 것은 아닙니다.
재현과 종료 확인
원자료 JSON의 observations 항목에 단계별 상태 코드와 본문이 있습니다. 독립 재현 스크립트는 실험 종료 시 자신이 만든 서버와 대기 스레드만 종료하며 외부 서비스를 호출하지 않습니다.
이번에 확인한 것은 응답 상태의 분리입니다. 작업 완료, 데이터 일관성, 재시도 성공이나 실제 이용자 기능을 검사한 것은 아닙니다. 배포된 HTML 자체가 맞는지 확인하고 싶다면 펀치블로그의 HEAD·GET 배포 확인 실험을 이어서 읽을 수 있습니다.
편집자 의견
상태 확인 주소를 만들 때는 무엇이 고장 났을 때 어떤 조치를 할지부터 정하겠습니다. 프로세스가 살아 있는지와 필요한 작업을 받을 준비가 됐는지를 한 응답으로 합치면 의존성 장애에 불필요한 재시작을 반복할 수 있습니다.
모든 외부 의존성을 항상 생존 검사에 포함하지는 않겠습니다. 준비 실패 때 트래픽을 줄일지, 이전 자료로 제한된 서비스를 할지처럼 실제로 취할 행동에 맞춰 통과 조건을 나누는 편을 권합니다.
판단 근거: 200 응답이 틀린 것이 아니라 질문이 다르다
의견 추가 2026-10-23 · 본문 자료를 바탕으로 한 편집 판단
실험 환경과 원자료
관찰 시각: 2026-10-13T13:02:12.768220+09:00
python: 3.10.12 · server: Python ThreadingHTTPServer · binding: 127.0.0.1:자동 배정 포트
Python 3.10.12 표준 라이브러리 · 루프백 격리 실험 · 운영 서비스 변경 없음
확인하지 않은 범위: 실제 DB·외부 API·작업 완료·Kubernetes·운영 부하를 시험하지 않았습니다.
Python 3 표준 라이브러리 · 관리자 권한과 외부 네트워크 불필요 자신이 만든 서버·스레드만 종료합니다. 운영 서비스와 다른 사이트에 접근하지 않습니다.
python3 lab-readiness-worker.py --output new-observations.json참고한 공식 문서
원고 수정: 2026-10-24 · 정정 요청
이 글의 보완 기록
- · 8개 루프백 응답을 관찰하고 원자료·독립 재현 스크립트를 공개했습니다.
- · 실제 운영 작업이 멈춘 사고처럼 읽힐 수 있는 제목을 격리 실험의 대역·준비 조건에 맞췄습니다. 원래 실험일과 관찰값은 유지했습니다.
- · 본문 근거에 대한 편집자의 판단과 결론이 달라지는 조건을 추가했습니다. 기존 관찰일·공식 자료 확인일은 유지했습니다.
- · 글별 적용 사례와 반례를 보강했습니다. 기존 관찰일과 원자료 확인일은 유지했습니다.