gzip on을 설정했는데 저장한 파일 크기는 그대로라면 압축이 적용되지 않은 것일까? 요청에서 압축을 허용했는지, 대상 파일이 압축 조건에 맞는지, 사용하는 도구가 이미 압축을 풀었는지 나누어 봐야 한다. 이번에는 작은 Nginx를 별도로 실행하고 같은 원문을 다른 요청 헤더로 읽어 결과를 비교했다.
합성 텍스트와 짧은 파일을 준비했다
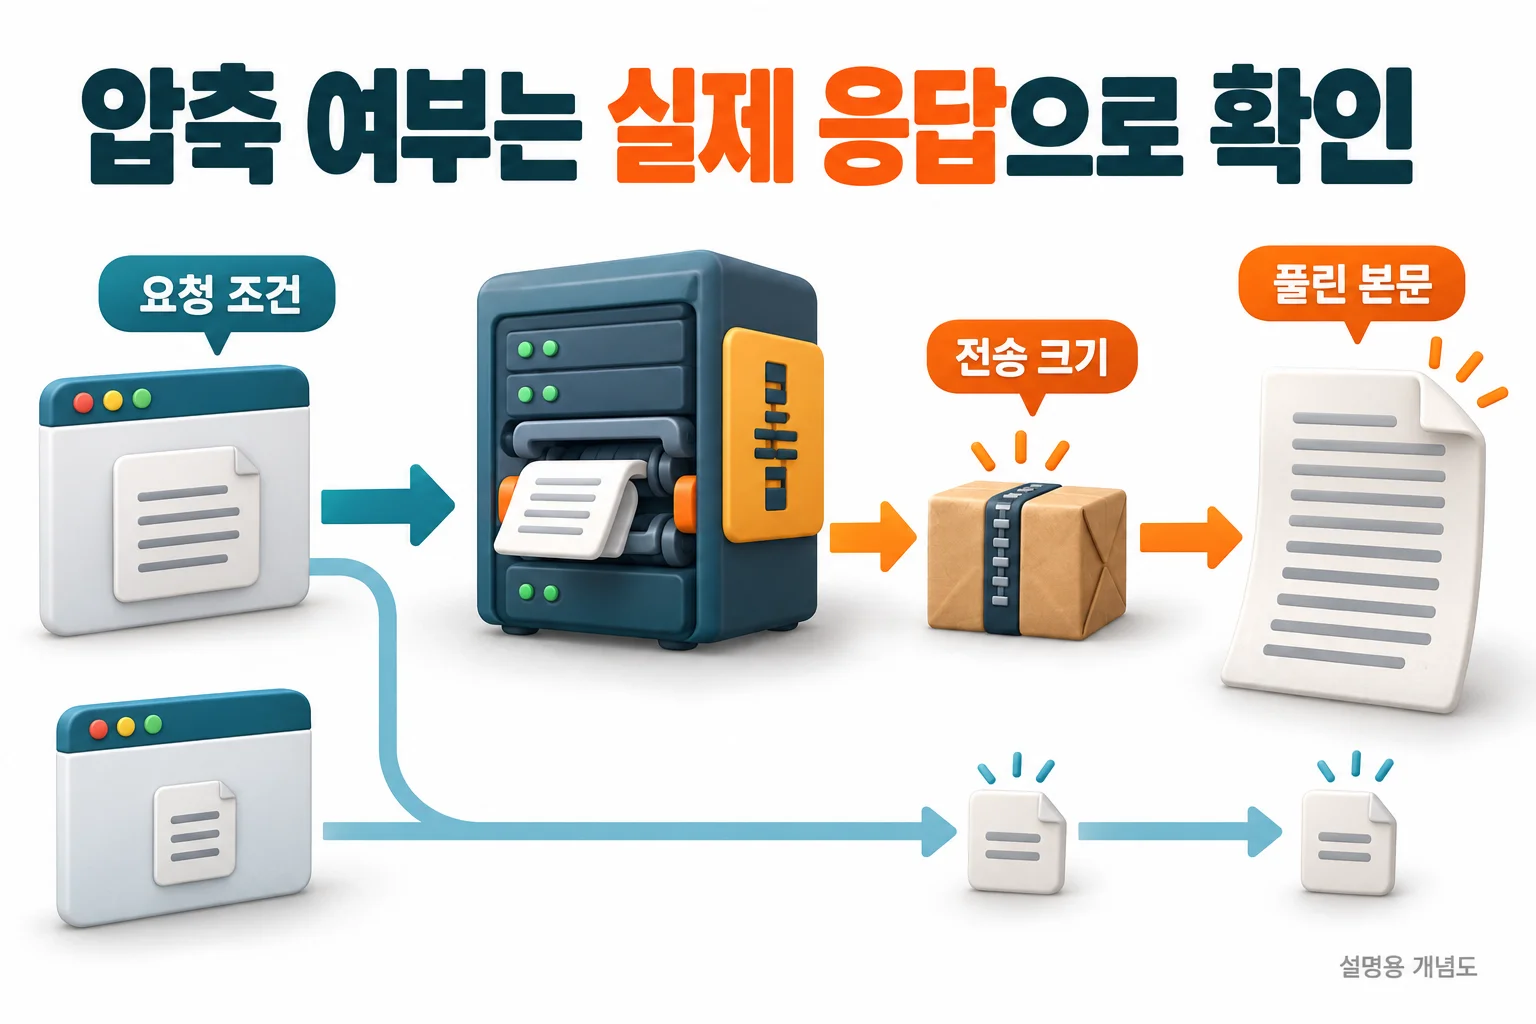
긴 파일은 번호만 다른 한국어 문장 80줄로 만들었다. UTF-8 기준 6,160바이트다. 짧은 파일은 ok와 줄바꿈을 합친 3바이트다. 반복이 많은 의도적인 실험 자료이므로 실제 블로그 글이나 이미지 파일의 압축률을 대표하지 않는다. 요청은 루프백 HTTP/1.1로 보냈고 HTTPS와 CDN은 거치지 않았다.
gzip on;
gzip_min_length 256;
gzip_comp_level 1;
gzip_types text/plain;
gzip_vary on;
Nginx 1.18.0에서 text/plain을 대상으로 최소 길이를 256바이트로 지정했다. 긴 파일은 Accept-Encoding: identity와 Accept-Encoding: gzip으로 각각 요청했고, 짧은 파일도 gzip을 허용해 요청했다. 전체 서버 설정은 원자료 JSON과 재현 스크립트에 포함돼 있다.
| 대상·요청 | Content-Encoding | 압축 상태 본문 | 복원 후 본문 | 원문 일치 |
|---|---|---|---|---|
| 긴 파일 / identity | 없음 | 6160 | 6160 | True |
| 긴 파일 / gzip | gzip | 317 | 6160 | True |
| 짧은 파일 / gzip | 없음 | 3 | 3 | True |
표의 본문 크기 단위는 바이트다. identity로 요청한 긴 파일에는 Content-Encoding이 없었고 본문은 6,160바이트였다. gzip 요청에서는 Content-Encoding: gzip과 함께 317바이트를 읽었다. 이를 Python gzip 모듈로 풀면 다시 6,160바이트가 됐고 원래 파일과 바이트 단위로 일치했다. 압축된 데이터가 작다는 것과 내용이 정확하게 복원된다는 것을 함께 확인한 결과다.
짧은 파일이 압축되지 않은 것은 이 설정의 예상 결과다
3바이트 파일은 gzip을 허용해 요청해도 Content-Encoding 없이 3바이트로 돌아왔다. 이 실험은 256바이트 이상을 압축 대상으로 정했으므로 짧은 파일의 결과만 보고 gzip 설정 전체가 실패했다고 판단하면 안 된다. 공식 문서는 gzip_min_length의 길이 판단에 응답의 Content-Length가 쓰인다고 설명한다. 이번에는 길이가 정해진 정적 파일만 대상으로 했다.
동적 응답, 다른 MIME 유형, Via 헤더가 있는 요청, 다른 HTTP 버전에서는 추가 조건이 관련될 수 있다. 그 모든 조합을 이번에 측정한 것은 아니다. 먼저 길이가 충분하고 압축 대상 유형이 확실한 같은 파일을 두 조건으로 요청하면 조사 범위를 좁힐 수 있다.
압축된 크기와 풀린 크기를 혼동하지 않기
실험은 Python http.client로 응답을 읽었다. HTTP의 chunk 구분은 제거하지만 gzip 내용은 자동으로 풀지 않으므로 그 상태의 바이트 수를 셀 수 있었다. 반면 압축 해제를 요청한 클라이언트에서 저장한 파일은 이미 원문 크기로 돌아와 있을 수 있다. 파일 크기가 같다는 관찰만으로 전송 중 압축 여부를 판단할 수 없는 이유다.
# 실제로 존재하는 충분히 긴 텍스트 파일 주소로 바꾼다.
# --compressed를 넣지 않아 압축된 본문을 파일에 보관한다.
curl -sS -D gzip-headers.txt -H 'Accept-Encoding: gzip' \
  -o response.gz https://example.com/sample.txt

# Content-Encoding: gzip인지 먼저 확인한 뒤 검사한다.
python3 - <<'CHECK'
import gzip
from pathlib import Path
raw = Path('response.gz').read_bytes()
plain = gzip.decompress(raw)
print('압축 상태:', len(raw), '복원 후:', len(plain))
CHECK
서버가 gzip을 보내지 않았는데 파일 확장자만 .gz로 저장할 수도 있다. 그러므로 예제의 압축 해제 단계 전에 응답 헤더를 확인해야 한다. 원문 일치까지 검증하려면 비교 가능한 원본 파일 또는 같은 버전의 비압축 응답이 필요하다. 사이트가 요청 사이에 바뀌면 단순 비교의 전제가 달라진다.
Content-Length가 없어도 압축된 본문은 존재했다
긴 파일의 gzip 응답에서는 Content-Length가 없고 Transfer-Encoding: chunked가 관찰됐다. identity 응답에는 Content-Length: 6160이 있었다. 따라서 이 결과에서 Content-Length만 찾아 압축 크기를 계산할 수는 없었다. 표의 317바이트는 실제로 읽은 gzip 본문의 길이이며, HTTP 헤더·chunk 구분·TCP 전송량을 모두 합친 네트워크 사용량은 아니다.
긴 파일의 두 응답에는 Vary: Accept-Encoding도 있었다. 이 헤더는 응답 선택에 해당 요청 헤더가 관련된다는 신호다. 이번에는 캐시 서버를 두지 않았으므로 CDN이 두 표현을 실제로 어떻게 저장하고 재사용하는지 검증한 것은 아니다.
| 압축이 안 보일 때 | 확인할 증거 | 다음 판단 |
|---|---|---|
| 요청이 압축을 허용했는가 | Accept-Encoding | gzip 요청과 일반 요청을 나누어 비교 |
| 응답이 gzip인가 | Content-Encoding | 파일명 .gz나 Content-Length만으로 단정하지 않기 |
| 형식·길이 조건에 맞는가 | 실제 Content-Type과 적용 설정 | 짧은 파일·다른 형식·적용 location 확인 |
| 클라이언트가 풀어 저장했는가 | curl의 --compressed 사용 여부 | 전송 바이트와 압축 해제 후 바이트를 구분 |
표의 순서대로 확인하면 설정을 무작정 더 강한 압축 수준으로 바꾸기 전에 조건 불일치를 찾을 수 있다. 이 실험의 합성 문장은 반복이 많다. 6,160 → 317바이트를 자신의 이미지·JSON·HTML 전체의 절감률로 사용하지 않는다.
운영에 적용할 때는 크기와 비용을 함께 본다
| 확인 항목 | 이번 결과로 알 수 있는 것 | 추가로 확인할 것 |
|---|---|---|
| 압축 후 바이트 | 합성 텍스트의 본문이 작아짐 | 실제 문서·자산별 절감량 |
| 원문 대조 | 해제한 본문이 원본과 일치 | 동적 콘텐츠의 버전 일치 |
| 처리 비용 | 측정하지 않음 | CPU·응답 지연·캐시와의 조합 |
| 다른 환경 | 루프백 HTTP/1.1만 확인 | 공개 HTTPS·프록시·브라우저 응답 |
압축 수준을 올리면 항상 사이트가 더 빨라진다고 결론 내릴 수는 없다. 이번 글은 수준 1에서 본문 크기만 비교했고 시간을 측정하지 않았다. 운영 설정 변경 여부는 실제 응답 크기와 처리 비용을 보고 판단해야 하며, 이미 압축된 이미지나 다른 콘텐츠 유형에도 같은 비율을 기대하지 않는다.
편집자 의견
압축 설정의 판단 기준은 모든 응답에 gzip이 붙는지보다 압축 대상의 크기·형식과 실제 전송 결과가 맞는지에 두겠습니다. 짧은 파일이 압축되지 않은 것은 이 실험에서 오류가 아니라 설정에 따른 결과였습니다.
브라우저가 해제한 본문 크기를 전송 크기와 비교하지 않겠습니다. 실제 서비스의 속도 개선을 주장하려면 이 합성 파일 비교에 더해 네트워크·캐시·측정 조건을 맞춘 별도 관찰이 필요합니다.
판단 근거: 짧은 파일이 압축되지 않은 것은 이 설정의 예상 결과다
의견 추가 2026-10-23 · 본문 자료를 바탕으로 한 편집 판단
실험 환경과 원자료
관찰 시각: 2026-09-13T03:08:02.184331+00:00
os: Linux · python: 3.10.12 · nginx: nginx version: nginx/1.18.0 (Ubuntu)
임시 Nginx, 루프백 HTTP/1.1. 번호만 다른 한국어 합성 문장 80개와 3바이트 파일. HTTP chunk 구분을 제거한 압축 상태의 본문 바이트를 측정하고 압축 해제 후 원문과 대조.
확인하지 않은 범위: 실제 글의 압축률, 처리 시간, CPU 사용량, 사용자 로딩 속도, TLS, CDN, Brotli, 브라우저 캐시는 측정하지 않았다.
Python 3과 Nginx가 있는 Linux 실험 환경에서 실행합니다. 별도 루프백 Nginx를 시작하고 자신이 만든 프로세스만 정리합니다. 임시 파일과 스크립트가 만든 자식 프로세스만 사용하며, 기존 결과 파일은 덮어쓰지 않습니다.
python3 lab-gzip-response.py --output new-observations.json참고한 공식 문서
원고 수정: 2026-10-24 · 정정 요청
이 글의 보완 기록
- · 요청 헤더·콘텐츠 형식·길이·클라이언트 해제 여부의 진단표를 추가했다.
- · 본문 근거에 대한 편집자의 판단과 결론이 달라지는 조건을 추가했습니다. 기존 관찰일·공식 자료 확인일은 유지했습니다.
- · 글별 적용 사례와 반례를 보강했습니다. 기존 관찰일과 원자료 확인일은 유지했습니다.