작은 사이트의 데이터를 SQLite 파일 하나에 저장하면 백업도 그 파일을 복사하면 끝날 것처럼 보인다. 그러나 파일이 열리고 검사 결과가 정상이라는 사실만으로 최신 글까지 보관했다고 판단할 수는 없다. 이 글은 실제 사이트의 데이터를 건드리지 않고, 합성 메모 16개로 그 차이를 재현한 기록이다.
먼저 결론: 무결성과 최신성은 따로 확인한다
이번 실험에서 DB 본체만 복사한 파일은 PRAGMA integrity_check 결과가 ok였다. 하지만 원본의 메모 16개 중 마지막 4개가 없었다. 같은 시점에 Python의 SQLite backup API로 만든 파일은 16개를 모두 담았고, 별도 경로로 옮겨 다시 열어도 조회 내용이 일치했다. 백업 작업의 종료 코드 외에 복구본에서 무엇을 읽을 수 있는지 확인해야 하는 이유다.
어떤 조건에서 4개가 빠졌나
임시 DB의 journal_mode를 WAL로 바꾸고 자동 checkpoint를 끈 뒤 메모 1~12번을 넣었다. 여기서 checkpoint(TRUNCATE)를 실행해 먼저 들어간 데이터를 DB 본체에 반영했다. 이어 13~16번을 넣고 commit했다. 연결은 계속 열어 둬 WAL 파일이 존재하도록 했고, 복사 중에는 새 데이터를 쓰지 않았다. 의도적으로 만든 정지된 상태이며, 바쁜 운영 DB를 복사하는 상황을 흉내 낸 것은 아니다.
PRAGMA journal_mode=WAL;
PRAGMA wal_autocheckpoint=0;
-- 실험 스크립트에서 메모 1~12 삽입 후 commit
PRAGMA wal_checkpoint(TRUNCATE);
-- 메모 13~16 삽입 후 commit, 연결 유지
SQLite 공식 문서가 설명하는 WAL 방식에서는 commit한 변경이 먼저 WAL에 기록될 수 있고, checkpoint가 이를 본체로 옮긴다. 따라서 이 상태의 본체만 떼어 내는 것은 DB 상태 전체를 보관하는 것과 다르다. 위 설정은 누락을 눈으로 확인하려고 사용한 실험 조건이다. 운영 DB에서 자동 checkpoint를 끄라는 권장은 아니다.
복사부터 복구까지 같은 기준으로 대조했다
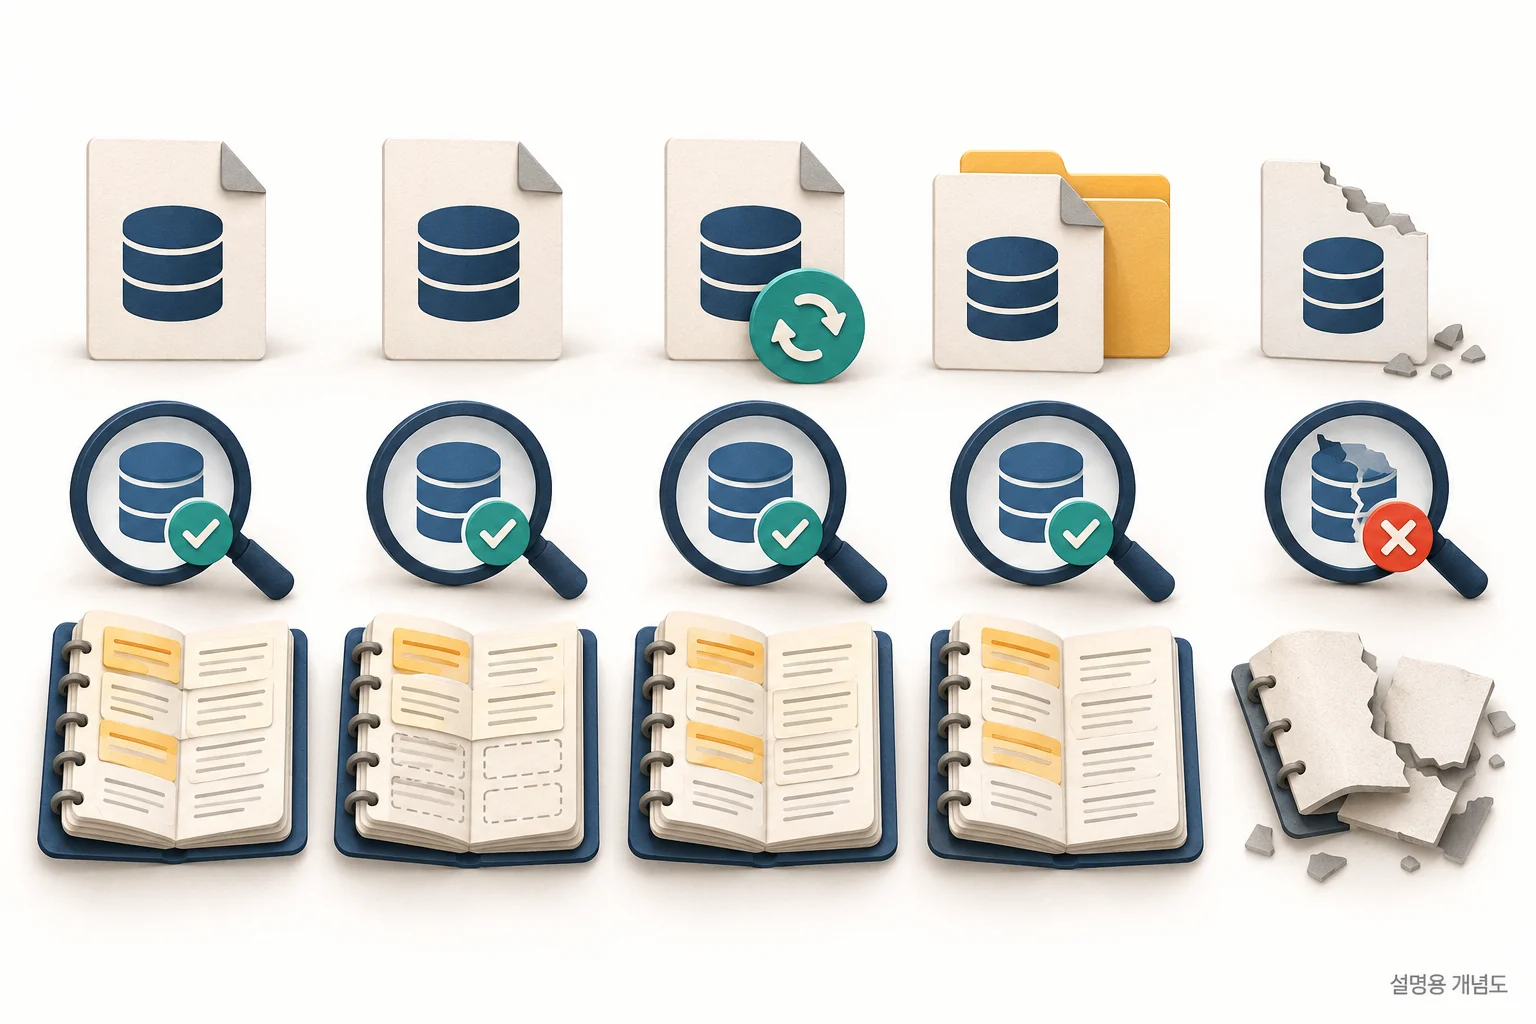
| 대상 | 메모 수 | 무결성 검사 | 원본 내용과 대조 |
|---|---|---|---|
| 검사 시점 원본 | 16 | ok | 일치 |
| DB 본체만 복사 | 12 | ok | 불일치 |
| backup API 결과 | 16 | ok | 일치 |
| 별도 경로에서 복구 | 16 | ok | 일치 |
| 100바이트로 잘린 복사본 | 조회 불가 | DatabaseError | 불일치 |
각 파일을 읽기 전용 연결로 열어 무결성 검사, 행 수, 마지막 ID, ID 순서로 정렬한 전체 메모 내용을 확인했다. 원자료의 SHA-256은 DB 파일 자체가 아니라 조회한 행을 JSON으로 직렬화한 내용의 해시다. 파일 내부 배치가 달라도 같은 메모인지 비교하려는 선택이다. 이 작은 데이터에서는 전체 대조가 가능했지만 대용량 서비스에서는 별도의 검증 설계가 필요하다.
일부러 100바이트만 남긴 복사본도 만들었다. 이 파일은 DatabaseError로 읽을 수 없었다. 잘린 파일은 검사 단계에서 걸렸고, 최신 4개가 빠진 파일은 형식 검사만으로 걸리지 않았다. 두 실패를 구분하지 않으면 “백업 검사 성공”이라는 메시지를 과신하기 쉽다.
- 파일이 열리는가
손상되거나 잘린 백업은 구조 검사에서 걸릴 수 있다.
- 필요한 데이터가 있는가
무결성이 ok여도 최신 메모가 빠질 수 있다.
- 복원 후 기능이 되는가
별도 경로의 복구본에서 실제 필요한 조회를 대조한다.
완성된 백업 파일을 만든 뒤 다시 열기
from pathlib import Path
import sqlite3

# 별도로 준비한 합성 notes DB를 전제로 한 조각
source = Path('source.sqlite3').resolve()
target = Path('backup-new.sqlite3').resolve()
# 원본이 없으면 실패한다. 빈 원본 DB를 새로 만들지 않는다.
src = sqlite3.connect(source.as_uri() + '?mode=ro', uri=True)
try:
    # 기존 백업을 덮어쓰지 않는다. 매 실행 새 이름을 정한다.
    with target.open('xb'):
        pass
    dst = sqlite3.connect(target)
    try:
        src.backup(dst)
    finally:
        dst.close()
finally:
    src.close()

check = sqlite3.connect(target.as_uri() + '?mode=ro', uri=True)
try:
    print(check.execute('PRAGMA integrity_check').fetchall())
    print(check.execute('SELECT count(*), max(id) FROM notes').fetchone())
finally:
    check.close()
이 코드는 글의 합성 notes 테이블을 전제로 한다. 실제 적용에서는 기존 백업을 바로 덮어쓰기보다 새 경로에 결과를 만들고, 검증이 끝난 파일을 보관 대상으로 정하는 편이 판단하기 쉽다. Python 공식 문서는 backup 메서드가 다른 클라이언트의 접근 중에도 동작한다고 설명하지만, 이번 측정에서는 동시 쓰기를 실행하지 않았다. 원본이 계속 바뀌면 비교할 기준 시점도 별도로 정해야 한다.
위 조각은 테이블을 만드는 전체 프로그램이 아니다. 준비한 source.sqlite3가 없으면 읽기 전용 연결에서 중단되고, backup-new.sqlite3가 있으면 배타적 생성에서 중단된다. 실행 도중 실패해 남은 대상 파일은 완료된 백업으로 취급하지 않는다. 처음 재현하려면 하단 lab-sqlite-backup.py를 별도 환경에서 실행한다. 해당 스크립트는 임시 디렉터리 안에 합성 메모를 만들며, 그 임시 DB 경로를 위 조각에 제공하지는 않는다. 이 두 실행 방법을 섞지 않는다.
| 자신의 데이터로 바꿀 부분 | 정할 기준 |
|---|---|
| notes 테이블 | 서비스의 핵심 테이블·필수 관계 |
| count(*)·max(id) | 누락을 판별할 행 수·마지막 정상 데이터 |
| 전체 메모 내용 대조 | 비교 가능한 스냅샷 시점과 핵심 조회 결과 |
10월 17일 후속 실험: 16행이 모두 있어도 틀린 복구본
기존 실험은 메모 네 개가 빠진 사례였다. 그렇다면 행 수와 마지막 ID가 같으면 충분할까? 별도 합성 DB에 사용자 1명과 메모 16개를 만들고 backup API로 보관한 뒤, 연결을 모두 닫고 세 복구본을 만들었다. 하나는 그대로 두고, 하나는 첫 메모의 제목만 바꾸고, 다른 하나는 첫 메모가 없는 사용자 999를 참조하도록 바꿨다.
| 대상 | 행 수 / 마지막 ID | integrity_check | 외래 키 위반 수 | 기준 내용 대조 |
|---|---|---|---|---|
| 정상 복구본 | 16 / 16 | ok | 0 | 일치 |
| 제목만 바꾼 복구본 | 16 / 16 | ok | 0 | 불일치 |
| 없는 사용자 999를 참조 | 16 / 16 | ok | 1 | 불일치 |
세 파일은 모두 integrity_check가 ok였고 count(*)와 max(id)가 16이었다. 제목을 바꾼 파일은 외래 키 검사도 통과했지만 기준 내용과 달랐다. 없는 사용자를 참조하는 파일은 foreign_key_check에서 notes의 1번 행, users 참조 위반 한 건이 나왔다. 구조 검사, 선언된 관계 검사, 서비스 내용 대조가 서로 다른 문제를 찾았다.
-- 복구본을 읽기 전용으로 연 뒤 실행하는 검사 예시
PRAGMA integrity_check;
PRAGMA foreign_key_check;
SELECT count(*), max(id) FROM notes;
-- 아래 조회는 후속 실험의 notes(id,title,user_id) 스키마용
SELECT id, title, user_id FROM notes ORDER BY id;
SQLite 공식 문서는 integrity_check가 외래 키 오류를 찾지 않으므로 foreign_key_check를 사용하라고 설명한다. 다만 스키마에 외래 키를 선언하지 않았다면 빈 결과만으로 서비스의 모든 관계가 맞다고 볼 수 없다. 제목이나 주문 상태처럼 관계 규칙에 맞는 잘못된 값은 정상 시점의 기준 데이터 또는 업무 규칙과 대조해야 한다.
이 실험의 내용 해시는 ID로 정렬한 (id, title, user_id) 전체 행을 JSON으로 직렬화한 값이다. 원본이 변하지 않는 작은 합성 DB라 전체 비교가 가능했다. 계속 쓰는 운영 DB에서는 같은 기준 시점·조회 열·정렬·직렬화 조건을 정해야 하며, 나중의 원본과 해시가 다르다는 이유만으로 백업 실패를 단정하지 않는다.
복구 연습에서 확인할 순서
| 순서 | 확인할 것 | 통과해도 남는 질문 |
|---|---|---|
| 1. 별도 경로에 복구 | 운영 DB를 덮어쓰지 않고 읽을 수 있는가 | 필요한 권한과 프로그램 버전이 맞는가 |
| 2. 구조 검사 | integrity_check 결과 | 최신 데이터까지 있는가 |
| 3. 내용 대조 | 예상 행 수·마지막 데이터·핵심 조회 | 누락을 판별할 기준 시점이 있는가 |
| 4. 서비스 기능 확인 | 복구본으로 필요한 읽기 기능 실행 | 쓰기와 부가 파일도 복원 가능한가 |
사이트가 첨부파일을 DB 밖에 보관한다면 DB 복구만으로 게시글 화면이 온전히 돌아오지 않을 수 있다. 어떤 파일과 설정이 데이터의 일부인지 목록을 함께 두자. 또한 같은 디스크의 다른 폴더에 만든 복구본은 복구 절차를 시험할 뿐, 그 디스크의 고장에 대비한 별도 보관은 아니다.
이 결과를 적용할 수 있는 범위
이 글에서 확인한 것은 WAL 상태에서 본체 복사와 backup API의 결과가 달라진다는 점, 그리고 작은 복구본의 전체 메모가 일치한다는 점이다. 운영 DB의 백업 주기, 최대 허용 손실 시간, 복구 소요 시간은 측정하지 않았다. 운영에 반영할 때는 자신의 테이블과 복구 기준으로 검사를 바꾸고 실제 복구 시간을 따로 기록해야 한다.
편집자 의견
백업의 완료 기준은 파일 생성보다 복구한 자료가 필요한 시점까지 포함하는지에 두겠습니다. 실험에서 무결성 확인과 기대한 행 수의 일치가 다른 질문이었으므로, 열리는 파일이라는 사실만으로 충분한 백업이라 부르기 어렵습니다.
WAL 사용 여부와 복사 시점이 바뀌면 이 실험의 결과를 그대로 적용하지 않겠습니다. 복구용 사본에서 확인할 식별값이나 행 수를 미리 정하고 원본을 건드리지 않는 복구 검증을 함께 준비하는 편을 권합니다.
판단 근거: 먼저 결론: 무결성과 최신성은 따로 확인한다
의견 추가 2026-10-23 · 본문 자료를 바탕으로 한 편집 판단
실험 환경과 원자료
관찰 시각: 2026-09-12T15:06:18.239480+00:00
os: Linux · python: 3.10.12 · sqlite: 3.37.2
임시 디렉터리의 합성 메모 16개. 최초 12개 checkpoint 후 4개를 WAL에 commit. 복사 중 동시 쓰기 없음.
확인하지 않은 범위: 실제 운영 DB, 대용량, 동시 쓰기, 복구 시간, 저장 장치 장애, 암호화 백업은 시험하지 않았다.
Python 3이 있는 별도 Linux 실험 환경에서 실행합니다. Nginx 실험에는 Nginx도 필요합니다. 임시 파일과 스크립트가 만든 자식 프로세스만 사용하며, 기존 결과 파일은 덮어쓰지 않습니다.
python3 lab-sqlite-backup.py --output new-observations.json참고한 공식 문서
- SQLite WAL: checkpoint와 WAL 파일
- SQLite Online Backup API
- Python sqlite3.Connection.backup
- SQLite: integrity_check와 foreign_key_check의 검사 범위
원고 수정: 2026-10-29 · 정정 요청
추가 실험의 환경과 원자료
관찰 시각: 2026-10-17T03:51:17.725292+00:00
os: Linux · python: 3.10.12 · sqlite: 3.37.2
합성 사용자 1명·메모 16개를 backup API로 보관. 연결 종료 후 별도 복구본 3개 중 하나의 제목, 다른 하나의 사용자 참조만 변경. 구조·행 수·관계·전체 메모 내용을 대조.
확인하지 않은 범위: 변경은 백업 API 실패나 디스크 손상을 재현하지 않는다. 검사의 사각지대를 보이기 위한 의도된 데이터 수정이다. 동시 쓰기·대용량·외부 첨부파일·복구 시간은 미검증.
Python 3의 표준 sqlite3 모듈만 사용합니다. 실제 DB 경로를 전달하는 옵션은 없습니다. 임시 파일과 스크립트가 만든 자식 프로세스만 사용하며, 기존 결과 파일은 덮어쓰지 않습니다.
python3 lab-sqlite-restore-checks.py --output lab-sqlite-restore-checks-result.json이 글의 보완 기록
- · 구조·내용·기능 검사 흐름과 전체 재현 스크립트의 준비 조건을 보강했다.
- · 행 수·마지막 ID가 같은 불량 복구본을 새 격리 실험으로 대조했다. 원본 읽기 전용 연결과 기존 백업 덮어쓰기 방지를 예제에 반영했다.
- · 본문 근거에 대한 편집자의 판단과 결론이 달라지는 조건을 추가했습니다. 기존 관찰일·공식 자료 확인일은 유지했습니다.
- · 글별 적용 사례와 반례를 보강했습니다. 기존 관찰일과 원자료 확인일은 유지했습니다.