평소에는 읽히던 JSON 스냅샷이 갱신 시간에만 가끔 해석되지 않는다면, 생산자가 새 파일을 다 쓰기 전에 소비자가 읽은 것은 아닌지 살펴볼 수 있다. 이번에는 우연히 오류가 나기를 기다리는 대신 쓰기 절반 시점에 멈춰 읽는 순서를 만들었다. 파일을 쓰는 동안 독자가 무엇을 보게 되는지 비교하기 위한 실험이다.
어떤 순간을 읽었는지 고정했다
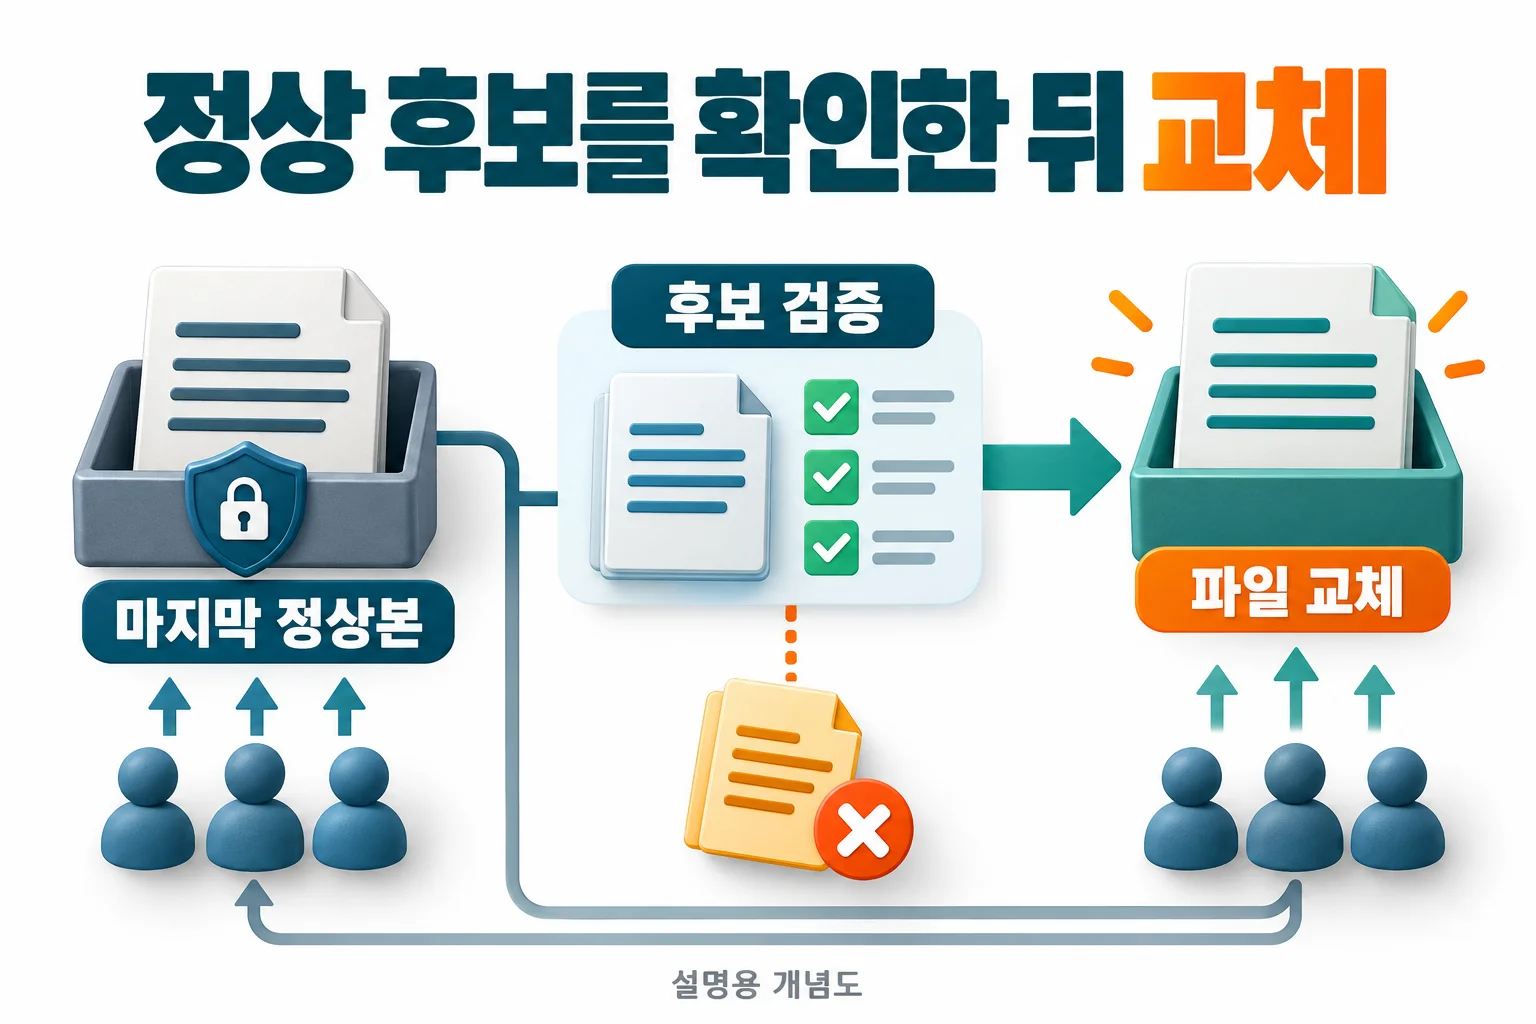
이전 스냅샷은 버전 1과 항목 3개, 새 스냅샷은 버전 2와 항목 5개로 만들었다. 첫 방식은 서비스 중인 파일을 wb로 열어 새 내용을 직접 썼다. 전체 바이트의 절반을 쓰고 flush한 다음 다른 파일 디스크립터로 같은 경로를 읽었다. 쓰기와 읽기를 순서대로 호출했으며 여러 프로세스의 부하를 재현한 것은 아니다.
두 번째 방식은 현재 파일을 그대로 두고 같은 디렉터리의 후보 파일에 새 내용을 썼다. 후보를 절반 쓴 동안에는 현재 파일을 읽고, 후보를 끝까지 쓴 다음 JSON 해석과 구조 검사를 통과했을 때 os.replace로 교체했다. 결과를 비교할 때는 조회 성공 여부뿐 아니라 버전과 항목 수도 확인했다.
| 읽기 시점 | JSON 해석 | 버전 | 항목 수 |
|---|---|---|---|
| 초기 파일 | ok | 1 | 3 |
| 직접 덮어쓰기 절반 시점 | JSONDecodeError | 조회 불가 | 조회 불가 |
| 임시 파일 쓰는 동안 현재 파일 | ok | 1 | 3 |
| 검증 후 교체 | ok | 2 | 5 |
| 구조가 틀린 후보 거절 후 | ok | 2 | 5 |
직접 덮어쓰기는 절반 시점에서 JSONDecodeError가 났다. 후보 파일을 쓰는 동안 현재 파일을 읽은 경우에는 버전 1과 항목 3개가 유지됐다. 검증 후 교체한 경로에서는 버전 2와 항목 5개가 나왔다. 즉, 이 순서에서는 새 데이터를 준비하는 동안 마지막 정상 스냅샷을 읽을 수 있었다.
flush와 파일 교체는 해결하는 문제가 다르다
flush는 Python의 버퍼에 남은 데이터를 파일 쪽으로 전달하기 위한 동작이다. 이번에는 부분 내용이 별도 읽기에 보이도록 의도적으로 호출했다. 파일 전체가 완성됐다는 표시가 아니며 전원 장애 후 디스크에 데이터가 남는다는 보장도 아니다. flush만 추가하면 독자가 완성된 JSON만 받는다는 결론을 내릴 수 없다.
Python 공식 문서에서 os.replace는 성공한 이름 변경의 원자성을 설명한다. 이 글의 해석은 독자가 보는 경로를 완성된 파일로 한 번에 바꾸는 데 이 동작을 쓰자는 것이다. 이미 열어 둔 파일 디스크립터, 서로 다른 파일시스템, 여러 writer의 경쟁, 저장 장치 장애까지 한 동작으로 해결된다는 뜻은 아니다.
JSON으로 읽힌다고 올바른 스냅샷은 아니었다
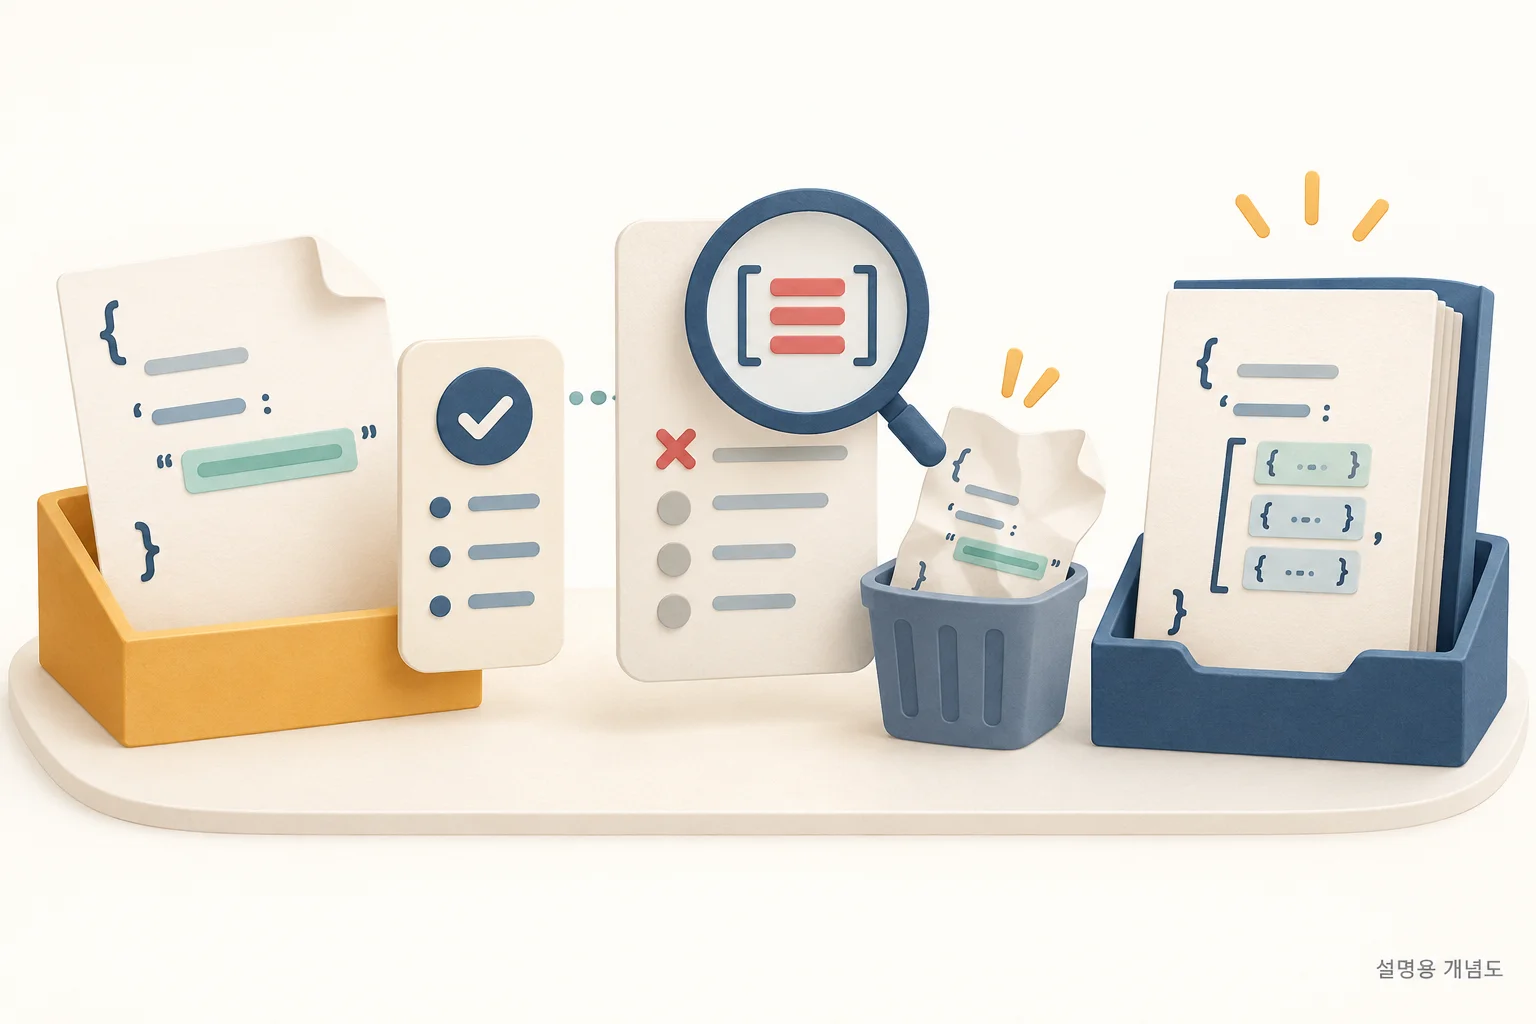
세 번째 후보는 문법적으로 유효하지만 items 값이 배열이 아닌 문자열인 JSON이었다. json.loads 자체는 성공했다. 추가 구조 검사는 이를 거절했고 교체를 실행하지 않아 현재 파일은 버전 2와 항목 5개를 유지했다. 따라서 새 파일 검사는 JSON 문법과 애플리케이션이 기대하는 형태를 나누어야 한다.
def validate_snapshot(data):
    if not isinstance(data, dict):
        raise ValueError("snapshot must be an object")
    if type(data.get("version")) is not int:
        raise ValueError("version must be an integer")
    if not isinstance(data.get("items"), list):
        raise ValueError("items must be a list")
    for item in data["items"]:
        if not isinstance(item, dict) or type(item.get("id")) is not int:
            raise ValueError("invalid item")
이 검사는 실험용 데이터 형태에 맞춘 최소 예다. 중복 ID, 허용 값, 필수 필드, 데이터의 신선도까지 검사하지 않는다. 실제로 조회에 필요한 조건을 정의하지 않고 검사 함수를 복사하면 문법은 맞아도 사용하지 못하는 데이터를 새 정상본으로 채택할 수 있다.
실패한 후보가 마지막 정상본을 지우지 않게 한다
| 처리 단계 | 실패했을 때의 선택 |
|---|---|
| 새 내용 수집·생성 | 현재 정상본을 유지하고 실패 기록 |
| 후보 파일 쓰기 | 후보만 정리하고 현재 파일은 그대로 유지 |
| 문법·구조 검사 | 검사 사유를 남기고 교체 중단 |
| 현재 경로로 교체 | 교체 성공 여부 확인 후 필요한 읽기 검사 |
독자에게 이전 데이터를 보여줘도 되는지와 언제부터 너무 오래됐다고 판단할지는 별도의 정책이다. 파일 내용에 마지막 성공 시각이나 버전을 담고, 갱신 실패를 운영자에게 구분해 알리는 편이 좋다. 이 실험의 버전 번호는 비교를 위한 값이며 실제 시간 기반 만료 정책을 구현한 것은 아니다.
교체 경로를 본문에서도 확인하기
다음은 위 validate_snapshot 함수와 함께 사용할 핵심 예시다. 새 스냅샷을 입력으로 받아 문법·구조 검사 후 같은 폴더의 고유 후보를 교체한다. 아래 예제의 실행 검수는 보강 자료에 따로 기록하며, 부분 쓰기 비교의 원자료와 구분한다.
import json
import os
import tempfile
from pathlib import Path

def publish_snapshot(target, data):
    target = Path(target)
    validate_snapshot(data)
    candidate = None
    try:
        with tempfile.NamedTemporaryFile(
            mode="w", encoding="utf-8", dir=target.parent,
            prefix=".snapshot-", delete=False
        ) as stream:
            candidate = Path(stream.name)
            json.dump(data, stream, ensure_ascii=False)
        validate_snapshot(json.loads(candidate.read_text(encoding="utf-8")))
        os.replace(candidate, target)
    finally:
        if candidate is not None and candidate.exists():
            candidate.unlink()
상위 폴더는 미리 존재해야 한다. NamedTemporaryFile로 만든 파일의 권한은 기존 파일의 권한을 복제하지 않는다. 서로 다른 서비스 계정이 읽는다면 게시 전에 필요한 소유권·권한을 설계해야 한다. 이 함수는 fsync 기반 전원 장애 내구성이나 여러 writer의 최신 순서까지 보장하지 않는다.
보강 실행에서 정상 후보는 버전 2·항목 5개로 교체됐다. 구조 오류와 JSON 직렬화 오류를 각각 넣었을 때는 그 정상본의 바이트가 유지됐으며 임시 후보도 남지 않았다. 교체된 파일의 권한은 이 환경에서 0600이었다. 기존 파일의 접근 권한이 자동으로 유지된다고 가정하면 안 되는 이유다.
| 입력 | 결과 | 유지된 버전 | 항목 수 | 남은 후보 파일 |
|---|---|---|---|---|
| 정상 후보 교체 | 성공 | 2 | 5 | 0 |
| 구조 검사 실패 | ValueError | 2 | 5 | 0 |
| 직렬화 실패 | TypeError | 2 | 5 | 0 |
파일 경로와 writer 수를 확인하고 적용한다
실제 프로그램에서는 충돌하지 않는 임시 파일 이름을 사용하고 현재 파일과 같은 파일시스템에 후보를 만드는지 확인한다. 후보 파일의 소유자와 접근 권한이 교체 후 읽기 프로그램에 맞는지도 중요하다. 실험은 한 사용자와 한 writer만 사용했으므로 서비스 계정 간 권한 전환을 검증하지 않았다.
두 writer가 각각 완성된 후보를 만들면 각 교체가 성공하더라도 더 오래된 데이터가 나중에 덮을 수 있다. 원자적 교체는 갱신 순서의 정확성을 자동으로 보장하지 않는다. 같은 서버의 중복 실행이 문제라면 관련 flock 실험이 다음 확인 지점이 될 수 있고, 여러 서버의 갱신 경쟁에는 추가 설계가 필요하다.
편집자 의견
스냅샷은 JSON 파싱 성공과 내용의 계약 검사를 함께 통과했을 때 게시하는 편을 권합니다. 문법상 읽을 수 있는 자료도 필요한 필드나 완전한 목록을 담지 않을 수 있어, 파일 교체만 안전하게 만드는 것으로는 부족했습니다.
원자적 이름 교체가 해결하는 읽기 중간 상태와 저장 장치의 내구성은 구분하겠습니다. 어떤 장애를 견뎌야 하는지 정한 뒤 검증·동기화·이전 사본 보존 중 필요한 절차를 선택합니다.
판단 근거: JSON으로 읽힌다고 올바른 스냅샷은 아니었다
의견 추가 2026-10-23 · 본문 자료를 바탕으로 한 편집 판단
실험 환경과 원자료
관찰 시각: 2026-09-13T03:07:31.801329+00:00
os: Linux · python: 3.10.12
같은 임시 디렉터리의 합성 JSON. 쓰기 절반에서 flush한 뒤 별도 파일 디스크립터로 읽는 순서를 고정했다. 동시 부하 실험이 아니다.
확인하지 않은 범위: 전원 장애·fsync 내구성·여러 writer·NFS·파일 권한 및 소유권 전환·디스크 부족·운영 스냅샷은 시험하지 않았다.
Python 3이 있는 Linux 실험 환경에서 실행합니다. 같은 임시 디렉터리 안의 합성 파일만 사용합니다. 임시 파일과 스크립트가 만든 자식 프로세스만 사용하며, 기존 결과 파일은 덮어쓰지 않습니다.
python3 lab-json-snapshot.py --output new-observations.json참고한 공식 문서
원고 수정: 2026-10-29 · 정정 요청
추가 실험의 환경과 원자료
관찰 시각: 2026-09-21T16:24:10.555339+00:00
os: Linux · python: 3.10.12
본문의 validate_snapshot·publish_snapshot 함수로 임시 경로에서 정상 교체, 구조 오류, 직렬화 오류를 순서대로 확인했다. 오류 뒤 정상 파일 바이트와 남은 후보 수를 대조했다.
확인하지 않은 범위: 단일 사용자·단일 writer. fsync·전원 장애·권한 전환·NFS·동시 writer·디스크 부족은 검증하지 않았다.
Python 3이 있는 별도 로컬 환경에서 실행합니다. 네트워크와 관리자 권한은 필요하지 않습니다. 임시 파일과 스크립트가 만든 자식 프로세스만 사용하며, 기존 결과 파일은 덮어쓰지 않습니다.
python3 lab-snapshot-publish.py --output lab-snapshot-publish-result.json이 글의 보완 기록
- · 후보 생성·검증·교체·정리를 포함한 본문 예제와 권한 전제를 추가했다.
- · 본문 근거에 대한 편집자의 판단과 결론이 달라지는 조건을 추가했습니다. 기존 관찰일·공식 자료 확인일은 유지했습니다.
- · 글별 적용 사례와 반례를 보강했습니다. 기존 관찰일과 원자료 확인일은 유지했습니다.